はじめに
手ぬぐい作家「つねかめ堂」のHP(https://tsunekame.com/)を作って運用しています。載せているのは、出店予定・Instagramの最新投稿・これまでの出店履歴という、イベント出店をする作家なら誰でも欲しくなる情報です。行った県が塗られていく日本地図も付いています。
作るにあたっての条件は3つでした。
- 更新する人はエンジニアではありません。 Googleカレンダーに出店予定を入れる、Instagramに投稿する。普段やっていることの延長で情報が更新されてほしい
- 運用費はほぼゼロにしたい。 サーバも有料SaaSも増やさない
- 放っておいても情報が古くならないこと。 終わった出店がトップに残り続けるようなサイトにはしたくない
結果として、フレームワークもCMSも使わないHTML1枚の静的サイトに、GitHub Actionsを4本住まわせる構成になりました。この記事では、その全体像と、作っている途中で効いた小技をまとめて紹介します。ひとつひとつを掘り下げると長くなるので、ここでは要点だけにとどめました。
全体像
無人で動くCIが4本あります。それぞれが独立した1本道なので、上から順に読めます。
- ① サイトの更新(1日3回・Update feeds) — Googleカレンダーの出店予定とInstagramの最新投稿を取ってきて、
public/index.htmlの決められた範囲に焼き込んでcommit & pushします。pushがそのままCloudflare Pagesのデプロイです - ② 広報文の下書き(日次・Promo drafts) — 出店の告知文とお礼文の下書きをAIに書かせ、GitHub Issueに投げます。同じ内容がTelegramにも届きます
- ③ アクセス解析(月次・Analytics report) — アクセス数・技術SEOの自己診断・売上サマリーを集めてレポート化し、Issueにします
- ④ 出没情報(日次・LINE profile) — LINE公式アカウントのプロフィールに貼る「出没情報」テキストを組み立ててTelegramに送ります
人がやることは3つだけです。Issueに出てきた広報文をInstagramに貼る。Telegramに届いたテキストをLINEに貼る。あとはmainへのマージを承認する。 それ以外は勝手に進みます。
以下、効いている小技を順に挙げていきます。
サイト本体はHTML1枚
public/index.html にHTML・CSS・JSが全部入っています。ビルドステップはありません。package.json の依存はこれだけです。
{
  "scripts": {
    "test": "node --test scripts/*.test.mjs",
    "test:e2e": "playwright test"
  },
  "devDependencies": {
    "@playwright/test": "^1.48.0"
  }
}配信物の依存はゼロで、テスト用のPlaywrightだけがdevDependenciesにいます。ビルドスクリプト(scripts/)もNode組み込みのfetchしか使いません。
理由は単純で、このサイトの寿命のほうがフレームワークの寿命より長そうだからです。年に数回しか触らないサイトで、久しぶりに開いたらnpm installが通らない、という事故をなくしたかった。実際いま触っても、cloneしてnode scripts/build-events.mjsが即座に動きます。
とはいえHTML1枚には弱点があります。出店予定をブラウザ側でfetchして描画していると、初期表示が遅く、検索エンジンにも中身が渡りません。 かといってビルド時にプリレンダすると、今度は「同じ描画ロジックがブラウザ用とビルド用の2箇所にできる」という、よくある分岐点に立たされます。
小技①:ブラウザで動いているコードを、ビルドがそのまま借りる
ここでやったのが、ブラウザに配っているコードを、Node側が抜き出してそのまま評価するという方法です。
index.html の<script>の中に、描画ロジックの純粋関数群をマーカーで囲んだブロックがあります。
// CAL-RENDER:START 出店予定リスト生成(純粋関数群・単一ソース)。
// scripts/build-events.mjs がこのマーカー間を抽出・評価し、ビルド時プリレンダで
// render() とバイト同一の HTML を生成する。ここでは document / fetch / el を
// 参照しないこと(Node の new Function でそのまま評価される)。
var WD = ['日','月','火','水','木','金','土'];
// ...(buildCalHtml / hostRole / detectPref など約300行)
// CAL-RENDER:ENDビルド側は、このブロックを文字列として切り出してnew Functionで評価し、関数を受け取ります。
export function extractCalRender(html) {
  const s = html.lastIndexOf(RENDER_START);
  if (s < 0) throw new Error('CAL-RENDER マーカーが public/index.html に見つからない');
  const e = html.indexOf(RENDER_END, s + RENDER_START.length);
  if (e < 0) throw new Error('CAL-RENDER:END マーカーが START 以降に見つからない');
  const block = html.slice(html.indexOf('\n', s) + 1, e);
  return new Function(block + '\nreturn { buildCalHtml: buildCalHtml, findPref: findPref, detectPref: detectPref, hostRole: hostRole };')();
}
new Functionは普通なら避ける手ですが、ここで評価しているのは自分がコミットした自分のindex.htmlです。外から来た文字列ではありません。得られるものは大きくて、ロジックの正本が1箇所になります。
この関数群を借りているのは3つのビルドスクリプトです。出店予定リストを作るbuild-events.mjs、過去の出店を追記するbuild-past.mjs、そして広報文を書くbuild-promo-drafts.mjs。
たとえば「このイベントは自分が主催なのか、共催なのか、ただの参加なのか」という判定。これはトップの一覧に出すバッジ、JSON-LDのorganizer、そしてAIに書かせる広報文のトーン、と3箇所で必要になるのに、判定ルールはどう考えても1つであるべきものです。正本をindex.htmlに置いて全員が借りる形にしたので、ミラーが存在しません。
細かい工夫が2つあります。
探索がlastIndexOfなのには理由があります。 本物のマーカーはファイル末尾近くの<script>内にあります。一方で、イベントの説明文にたまたま同じ文字列が入ってしまうと、それはプリレンダ済みの静的リストやJSON-LD、つまり本物より手前に現れます。後ろから探せば偽マーカーを拾いません。
ブロック内ではdocumentもfetchも参照しないことをコメントで縛っています。 Nodeで評価される以上これは破れない制約なので、破ったら気づけるようにテストも置いています。
小技②:マーカーの間だけを差し替え、外側は1バイトも触らない
生成したHTMLは、index.htmlのマーカーで囲まれた範囲に書き戻します。この差し替えを担当する関数がこれです。
export function replaceBetween(html, startMarker, endMarker, middle) {
  if (html.indexOf(startMarker) !== html.lastIndexOf(startMarker)) {
    throw new Error('START マーカーが複数あります');
  }
  if (html.indexOf(endMarker) !== html.lastIndexOf(endMarker)) {
    throw new Error('END マーカーが複数あります');
  }
  const startIdx = html.indexOf(startMarker);
  const endIdx = html.indexOf(endMarker);
  if (startIdx === -1 || endIdx === -1 || startIdx > endIdx) {
    throw new Error('マーカーが見つからない/順序が不正です');
  }
  const head = html.slice(0, startIdx + startMarker.length);
  const tail = html.slice(endIdx);
  return head + middle + tail;
}
短い関数ですが、必ず守らせているルールが2つあります。
マーカーの外は1バイトも変更しません。 だから同じ入力で再実行すれば差分はゼロです。CIが1日3回走っても、内容が変わらなければcommitは発生しません。
マーカーが0個・複数・順序不正なら、何も書かずにthrowします。 「見つからないので末尾に追記」みたいな親切をすると、事故が静かに進みます。壊れているなら止まってほしい。
そしてマーカー自身が、人間向けの説明を持っています。
<!-- CAL:START 自動生成: scripts/build-events.mjs が buildCalHtml と同一の静的リストを注入。手で編集しない -->
<!-- CAL:END -->半年後の自分は、ここが自動生成であることを確実に忘れています。「手で編集しない」と、編集しようとした場所に書いてあるのが一番効きます。
小技③:日本地図は1枚だけ置いて、CSS変数で県を光らせる
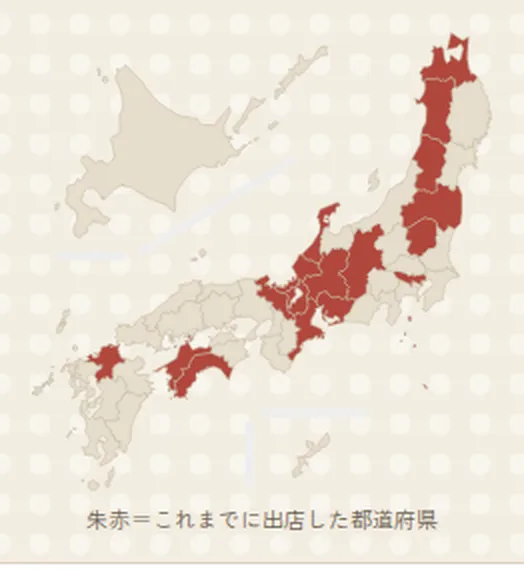
出店予定の各行には、その県だけが朱赤で光る小さな地図が付いています。「これまでの出店」には、行ったことのある県が塗られた全国地図があります。
素直に作ろうとすると、ここは急に重くなります。47都道府県のパスデータは巨大で、出店予定の行ごとにコピーしたらHTMLが膨れ上がります。 かといって県ごとにPNGを用意すると47枚。しかも「この県を光らせる」たびにJavaScriptでパスを探してfillを書き換えることになります。
やったのは3つです。
地図の実体は1回だけ置いて、あとは参照する。 白地図(geolonia/japanese-prefectures)を<defs>に1回だけ埋め込み、使う側は<use>1行で済ませます。
<svg width="0" height="0" aria-hidden="true" style="position:absolute"><defs><g id="jp-map">
  <g class="ishikawa prefecture" data-code="17" fill="var(--p17,#e6ddcc)" stroke="#c3b89f">...</g>
  ...47都道府県分...
</g></defs></svg>
点灯はCSS変数に任せる。 各県のfillがvar(--p17, #e6ddcc)になっているのがポイントで、変数の既定値が「塗っていない色」です。 光らせたい県は、その変数を定義するだけ。
<svg class="rmap" viewBox="430 330 460 460"><use href="#jp-map" style="--p17:var(--shu)"/></svg><use>は参照先のコピーをシャドウツリーとして展開しますが、CSS変数はその中まで継承されます。 だから同じ#jp-mapを参照していても、<use>ごとに違う県を光らせられます。JavaScriptでDOMを探して属性を書き換える処理は、どこにもありません。
地域の拡大はviewBoxを変えるだけ。 石川県なら中日本、秋田県なら東北、というように、同じ地図の「見る窓」をずらします。拡大画像を用意する代わりに、切り出し枠を7つ定数で持っているだけです。
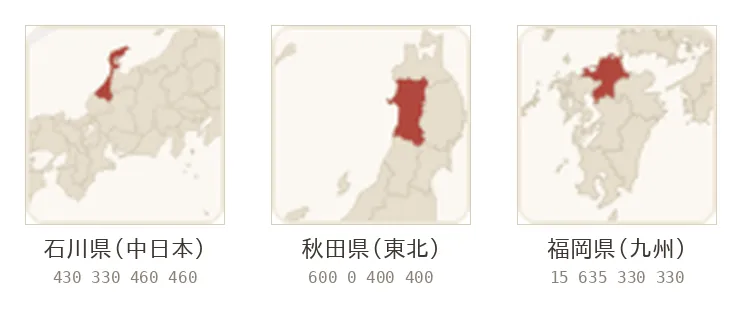
/* 地域クロップ: regionキー → [viewBox x, y, 一辺, 地域名](全国図 1000² からの切り出し枠) */
var RCROP={
  hokkaido:[20,0,660,'北海道'], tohoku:[600,0,400,'東北'], kanto:[700,395,265,'関東'],
  chunichi:[430,330,460,'中日本'], west:[150,460,365,'西日本'], kyushu:[15,635,330,'九州'], okinawa:[470,790,260,'沖縄']
};
そして全国の足あとマップは、過去の出店から県コードを集めて、変数をまとめて流し込むだけです。
evs.forEach(function(e){
  if(e.dp && !prefSet[e.dp.code]){ prefSet[e.dp.code]=1; vars.push('--p'+pad(e.dp.code)+':var(--shu)'); }
});
実際に配信されているHTMLでは、こうなっています。
<use id="past-use" href="#jp-map" style="--p23:var(--shu);--p05:var(--shu);--p20:var(--shu);--p39:var(--shu);...">気に入っているのは、この地図を誰も更新していないことです。 県の判定は会場の住所から自動で行われ(これも小技①でビルドが借りている関数のひとつ、findPrefです。正式名で拾えなければ「東京」「秋田」のような接尾辞なしでも拾います)、終わった出店はbuild-pastが日次で追記します。出店すれば、その県は勝手に朱赤になります。 塗り絵が少しずつ埋まっていくのは、作った側から見ても素朴に楽しいところです。
GitHub Actionsに“社員”を住まわせる
ここからは自動化の話です。CIをテスト実行係ではなく、定期的に何かを作って届けてくれる担当者として使っています。
小技④:事実はコードが所有し、AIは文章だけ書く
「AI広報社員」は、出店の告知文とお礼文の下書きを毎日作ります。
設計の中心はこれです。日付・会場・柄といった事実はすべてコードが所有し、AIに任せるのは文章だけ。
Geminiに渡すのは、コードが組み立て終わった事実と、お手本と、関連する過去投稿です。AIは日付を計算しませんし、会場名を思い出したりもしません。生成AIに書かせて一番怖いのは「もっともらしい嘘を公開してしまうこと」なので、嘘をつける余地のあるものを最初から渡さないという方針です。
そして返ってきたJSONが壊れていたり候補がゼロだったりしたら、throwしてIssueを作りません。 空のIssueが立つより、何も来ないほうがマシです。何も来なければ「今日は下書きが来ていないな」と気づけます。
月次の「AIアクセス解析レポート社員」も同じ作りです。アクセス数も前月比も技術SEOの診断結果も、全部コードが計算します。AIが書くのは講評だけ。ついでにWebのアクセス数と対面の売上を結びつけた講評は禁止にしています。両者は別チャネルなので、「サイトを見た人が買った」というファネルの話は根拠がないからです。
小技⑤:「採用:」コメントだけを学習して、文体が寄っていく
広報の下書きは、そのまま貼ることもあれば、手直しして貼ることもあります。この手直し後の最終文を回収する仕組みがあります。
Issueに人が「採用:」で始まるコメントを付けて閉じると、翌日のCIがそれを収穫して、お手本プール(promo-examples.json)に取り込みます。次回以降のfew-shotがそれになるので、使うほど文体が本人に寄っていきます。
ポイントはIssue本文の候補からは一切学習しないことです。本文にあるのは「AIが出した3案」であって、採用されたとは限りません。不採用案を学習すると、いつまでも直したい癖が残ります。学習するのは「人間が明示的に選んだ勝者」だけ、と決めています。
小技⑥:壊れ方を3種類に書き分ける
外部サービスを6つも束ねていると、どれかは必ず落ちます。落ちた時にどうするかを、用途ごとに変えています。
fail closed(絞れないなら何も渡さない) — 広報AIに渡してよいのは「つねかめ堂の手ぬぐいの柄」だけです。委託販売をしている店では、売上上位に他の作家さんの商品が並ぶことがあります。そこでSquareのカテゴリで絞り込むのですが、絞り込みに失敗したら素材ゼロで続行します。生の商品名にフォールバックはしません。
export function isPromoPattern(categoryNames, opts = {}) {
  const { deny = PROMO_DENY_CATEGORIES, allow = PROMO_ALLOW_CATEGORIES } = opts;
  if (hasDeniedCategory(categoryNames, deny)) return false;
  const cats = toSet(categoryNames);
  return allow.some((a) => cats.has(a));
}除外を許可より必ず先に評価しているのも同じ理由です。広報の失敗は「誤った断定を公開すること」なので、取りこぼしのほうが圧倒的に軽い。
graceful skip(落ちても本業は止めない) — 一方で、Squareが落ちたからといって広報の下書きが出ないのは困ります。売れ筋の柄は「あれば嬉しい素材」なので、取れなければ黙って省いて先に進みます。Squareの障害が広報を落とさないようにしてあります。
降格(数字は落とすが、落としたことは言う) — 月次レポートでアクセス解析が取れなかった時は、analytics=nullにしてレポート本文にバナーを出し、CIログに::warning::を出します。前月分だけが欠けた場合は、今月の数字自体は有効なので降格させず、前月比だけを省いて「なぜ省いたか」を本文に書きます。
momNote: '前月データが 0 件のため前月比は省略しました(トークンのスコープ/retention を確認してください)。',黙って消えた項目は、そのうち誰も気づかなくなります。消すなら理由を残す。
CI・運用まわりの小技
ここからは短く、独立した小ネタです。
小技⑦:actions/cacheをhash-as-keyに使って変更検知する
LINEの出没情報テキストは毎日組み立て直しますが、内容が変わっていない日に通知が飛ぶと、そのうち誰も読まなくなります。
そこで、生成したテキストのsha256をキャッシュのキーそのものにしました。
- name: Hash generated text
  id: hash
  run: echo "hash=$(sha256sum '${{ steps.build.outputs.text_path }}' | cut -d' ' -f1)" >> "$GITHUB_OUTPUT"

- name: Check sent-marker cache
  id: sent
  uses: actions/cache@v4
  with:
    path: .line-profile-sent-marker
key: line-profile-sent-${{ steps.hash.outputs.hash }}キャッシュヒット=同じ内容を前に送った、ミス=内容が変わった、という読み替えです。中身が何であるかはどうでもよく、キーが当たるかどうかだけを見ています。前回値を置くための場所を別に用意しなくて済みます。
小技⑧:workflow_runで「お礼の直後」を保証する
出店の最終日の夜、お礼の下書きが届きます。同じタイミングで、終わった出店を落とした新しい出没情報テキストも欲しい。
同時刻にcronを2本置いても順序は保証されませんが、workflow_runなら相手の完了後に起動します。
on:
  schedule:
    - cron: '0 21 * * *'   # 毎日 06:00 JST(保険)
  workflow_dispatch:
  workflow_run:
    workflows: ["Promo drafts"]
types: [completed]conclusionで絞っていないのが地味なポイントです。広報が落ちた日でも、予定が変わっていれば貼り替えは必要だからです。毎回起動はしますが、送るかどうかは小技⑦のハッシュが握っているので、うるさくはなりません。
小技⑨:タイムゾーンを2つ回して日付ズレを機械検証する
出店情報はJSTで動きますが、GitHub ActionsのランナーはUTCです。「今日」の解釈が1箇所ずれると、深夜帯だけ前日の予定が出る、というような踏みにくいバグになります。
strategy:
  fail-fast: false
  matrix:
tz: ['UTC', 'Asia/Tokyo']ランナーの既定がUTCなので、TZ=UTCを足すだけでは同じ環境を2回走らせることになります。JSTを明示した2ジョブにして、日付のズレを機械に検証させます。 実際にこの手のバグを踏んだので入れました。
小技⑩:通知されないCronを、別のCIから見張る
Instagramの投稿アーカイブは、Cloudflare WorkerのCronで6時間おきに取り込んでいます。ここで問題になったのが、Cloudflare の Cron は失敗しても誰にも通知しないことでした。GitHub Actionsから移した時に、失敗メールという通知経路も一緒に失っていたわけです。
なので、取り込みの生死をGitHub Actions側から見張っています。
// Cron は6時間おき。2回続けて落ちるまでは騒がない(一時的な障害で毎回メールが飛ぶと
// 誰も読まなくなり、本当に止まった時に気づけなくなる)。3回目を跨いだら異常とみなす。
export const MAX_AGE_HOURS = 14;見張り先の選び方にも一手あります。アーカイブ本体の更新を見てはいけません。 投稿が無ければアーカイブは更新されず、それは正常な状態です。「投稿していないだけ」と「取り込みが死んでいる」を区別できません。そこで、Cronが走るたびに必ず書く実行記録(ingest-status.json)の鮮度を見ています。
小技⑪:JPEGをgitの履歴から追い出す
もともとInstagramの画像をリポジトリに貯めていたのですが、これはやめました。JPEGはgitのdeltaが効かないので、毎回まるごと積み上がります。 年100MB近くが履歴に永久に残る計算でした。一度入れるとgit filter-repoしない限り消えません。
いまは正本をCloudflare R2のバケットに置き、リポジトリでは非追跡にしています。「後から消せないもの」をgitに入れない、という当たり前の話ですが、静的サイトだと画像をついpublic/に置いてしまいがちなので、意識的に線を引いています。
まとめ
改めて並べてみると、効いていた原則は4つでした。
正本を1つに保つ。 同じ判定が複数箇所で必要になったら、コピーするのではなく、1箇所から借りる方法を探す。new Functionでブラウザ用のコードを抜き出して使うのは強引ですが、同じロジックを2つ抱えるよりずっと安全でした。
事実と文章を分ける。 AIに任せるのは文章だけで、日付も数値も柄もコードが所有する。生成AIを運用に組み込む時、ここの線引きが一番効きました。
壊れ方を先に決める。 fail closed・graceful skip・降格。「落ちたらどうするか」を用途ごとに決めておくと、外部サービスがいくつあっても運用が静かになります。そして黙って消さない。省いたなら理由を出力に残す。
「誰も更新しないもの」に寄せる。 足あとマップが良い例で、出店すれば県が勝手に塗られます。手で更新する場所を作らなければ、そこは古くなりません。
個々の話はどれも掘れば長くなるので、ここでは駆け足になりました。特に「HTML1枚で正本を1つに保つ」話、「AIに事実を渡す」話、それに地図まわりは、それぞれ単体でも書ける分量があります。気が向いたらそのうち書くかもしれません。